 Palatine Speech
Расшифровка записей из Google Drive в n8n: шаблон с Palatine Speech
Бесплатный шаблон для n8n: новая запись звонка, встречи или лекции в выбранной папке Google Drive уходит в Palatine Speech, а текст сохраняется .txt-файлом в отдельную папку. Понадобятся учётные данные Google Drive, API-ключ Palatine Speech и n8n.
- Шаблон бесплатный
- 6 рабочих нод
- n8n Cloud и self-hosted
- Нода с открытым кодом (MIT)
- от 0,29 ₽/мин
- API в РФ (152-ФЗ)
Как работает шаблон
Шаблон «Transcribe Google Drive recordings to text files with Palatine Speech» из библиотеки n8n следит за одной папкой в Google Drive. Как только в ней появляется запись звонка, встречи или лекции, воркфлоу скачивает файл, отправляет его в Palatine Speech и сохраняет расшифровку обычным .txt-файлом в другую папку. Открывать при этом ничего не нужно: вы кладёте запись в папку и через какое-то время находите текст в папке расшифровок.
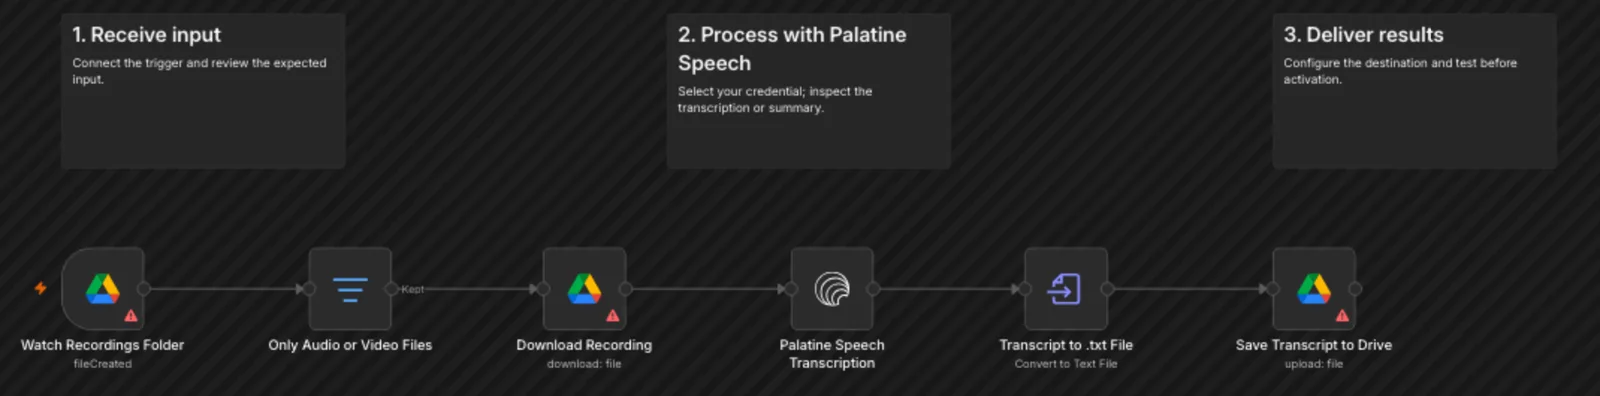
Шаблон на холсте n8n, фрагмент с нодами. Над нодами три заметки-раздела: «1. Receive input», «2. Process with Palatine Speech», «3. Deliver results»; слева от них при импорте появится большая заметка Read me с инструкцией. Красные значки на трёх нодах Google Drive исчезнут, когда вы выберете в них учётные данные.
В воркфлоу шесть рабочих нод. Триггер Google Drive отдаёт данные нового файла, фильтр отсекает всё, что не похоже на запись, дальше файл скачивается по его id. Нода Palatine Speech создаёт задачу распознавания и опрашивает её статус, пока не придёт результат. Текст из поля transcription превращается в файл, имя которого берётся от имени записи без расширения.
| Нода | Тип | Что делает |
|---|---|---|
| Watch Recordings Folder | Google Drive Trigger | реагирует на событие fileCreated в выбранной папке, опрашивает Drive каждую минуту |
| Only Audio or Video Files | Filter | пропускает файл, если его mimeType начинается с audio/ или video/, либо имя оканчивается на .mp3, .wav, .m4a, .ogg, .oga, .flac, .mp4, .webm, .aac, .opus, .mov или .mkv |
| Download Recording | Google Drive | скачивает файл по $json.id |
| Palatine Speech Transcription | Palatine Speech | операция Transcribe, модель palatine_large_highspeed, бинарное поле data |
| Transcript to .txt File | Convert to File | операция Convert to Text File, источник: поле transcription, имя записи без расширения плюс .txt |
| Save Transcript to Drive | Google Drive | загружает .txt в «Мой диск», папку вы выбираете сами |
Что понадобится до установки
Нужны три вещи: учётные данные Google Drive с доступом к обеим папкам, API-ключ Palatine Speech из личного кабинета и n8n, в котором можно поставить community-ноду. Сама нода называется n8n-nodes-palatine-speech, работу с ней проверяли на n8n 1.39.1 и новее. На своём сервере community-пакеты должны быть разрешены переменной N8N_COMMUNITY_PACKAGES_ENABLED=true. В n8n Cloud можно выбрать верифицированную ноду Palatine Speech, если она доступна в вашем рабочем пространстве.
С Google всё зависит от того, где стоит n8n. По документации n8n, в Cloud для поддерживаемых нод есть управляемый вход через Google, без настройки в Google Cloud Console (подходит ли он ноде Google Drive, видно в окне учётных данных). На своём сервере его нет: нужно создать проект в Google Cloud, включить нужный API, получить Client ID и Client Secret и вписать redirect URL из учётных данных n8n в список разрешённых у клиента OAuth.
Есть и подвох с режимом тестирования. Если приложение Google создано как внешнее и остаётся в статусе Testing, по документации n8n согласие и токены истекают через семь дней. Воркфлоу после этого начнёт падать на нодах Google Drive, пока вы не переподключите учётные данные в окне n8n. Для постоянной работы такой режим не подходит.
Установка по шагам
Порядок собран из описания шаблона на n8n.io и из заметок внутри самого воркфлоу. Сначала ноды и ключи, затем папки, а публикация в самом конце, после проверки.
- Установите ноду. На своём сервере откройте Settings → Community Nodes → Install и введите
n8n-nodes-palatine-speech. В n8n Cloud выберите верифицированную ноду Palatine Speech, если она доступна в вашем рабочем пространстве. - Добавьте шаблон в n8n со страницы шаблона на n8n.io или импортируйте файл google-drive-transcripts.json. В файле нет учётных данных.
- Создайте учётные данные Google Drive OAuth2 и выберите их во всех трёх нодах Google Drive: в триггере, в скачивании и в загрузке. В триггере Watch Recordings Folder выберите папку, которую нужно отслеживать.
- В ноде Palatine Speech Transcription создайте учётные данные Palatine Speech API: API Key возьмите в личном кабинете, Base URL оставьте
https://api.palatine.ru. - В ноде Save Transcript to Drive выберите отдельную папку для .txt. Фильтр Only Audio or Video Files не отключайте.
- Положите в наблюдаемую папку короткую запись, дождитесь результата и проверьте текст в папке расшифровок. Если всё на месте, опубликуйте воркфлоу.
Отдельная папка на пятом шаге закреплена в описании шаблона: авторы просят выбрать её явно. Фильтр и так отсечёт файл .txt, поэтому готовая расшифровка не запустит новый круг распознавания, но в одной папке записи и тексты быстро смешаются.
Проверять лучше на коротком файле. При ручном запуске триггер возвращает последнее подходящее событие, а если подходящих нет, выдаёт ошибку. Это стоит знать, чтобы не принять пустую папку за поломку. После публикации n8n, как сказано в его документации, регулярно проверяет папку и запускает воркфлоу на каждое найденное событие.
Ограничения шаблона
Главное ограничение шаблона связано с ожиданием результата. Нода Palatine Speech работает с API асинхронно: создаёт задачу и опрашивает её статус. В шаблоне блок настроек опроса пустой, поэтому действуют значения по умолчанию: Polling Interval (Ms) равен 500, а Max Poll Attempts равен 200. Это примерно 100 секунд ожидания, потом нода падает с ошибкой «Task … did not complete within polling limit (200 attempts)».
Для длинных записей лимит нужно поднять. Допустимы интервалы от 500 до 900 000 мс и от 1 до 1000 попыток. Например, интервал 5000 мс и 720 попыток дают окно ожидания около часа. Остальные ограничения собраны в таблице.
| Ограничение | Что произойдёт | Как обойти |
|---|---|---|
| Триггер опрашивает Drive раз в минуту | расшифровка стартует не сразу после загрузки записи | учитывать задержку или изменить расписание опроса в триггере |
| Фильтр пропускает .webm, а в списке форматов документации Palatine Speech WebM нет | API может отклонить такой файл | проверить на коротком файле или убрать webm из условия фильтра |
| Токены Google истекают через семь дней, если приложение в статусе Testing | ноды Google Drive начнут падать с ошибкой доступа | переподключить учётные данные или вывести приложение из тестового режима |
| На выходе простой текст без разметки по спикерам | в .txt нет реплик по ролям | заменить Transcribe на Diarize (см. ниже) |
Список форматов мы сверили с документацией: Palatine Speech принимает аудио AIFF, ASF, FLAC, M4A и AAC, MP3, OGG, Opus, WAV, а из видео AVI, MKV, MOV и MP4, причём у видео берётся только звуковая дорожка.
Как доработать шаблон
Самая простая доработка касается результата. Вместо Transcribe в ноде Palatine Speech можно выбрать Summarize со сценарием meeting_summary: он вернёт краткое содержание, решения и задачи, а через user_prompt задаётся своя структура ответа. Операция Diarize размечает, кто говорит, и умеет отдавать результат в SRT или VTT через параметр Response Format. Какое именно поле нода отдаёт на выходе в каждой операции, посмотрите в её результате и подставьте это поле в Convert to File вместо transcription. Готовую сводку из аудио и видео удобно складывать рядом с полной расшифровкой.
Дальше работают стандартные ноды n8n. Convert to File умеет не только текстовые файлы, но и CSV, HTML, JSON и XLSX, а нода Google Docs создаёт и обновляет документы, так что расшифровку можно писать в Google Docs, а не в .txt. Нода Google Drive умеет Move, поэтому обработанную запись можно переносить в папку «обработано», и входная папка останется чистой. Ссылку на готовый текст стоит отправлять команде в мессенджер или на почту, это один из вариантов, который предлагают и сами авторы шаблона.
Если вам нужна не папка в Drive, а другой источник записей, посмотрите соседние шаблоны: расшифровку голосовых из Telegram и свой эндпоинт /transcribe для вызова из любых систем.
Шаблон, кабинет или API: что выбрать
Шаблон выигрывает, когда записи копируются в Drive сами или регулярно, а текст нужен там же, где они лежат. Типичная картина: диктофон телефона синхронизируется с папкой, менеджеры сбрасывают туда звонки, преподаватель выкладывает лекции. Если файлов мало и они приходят вразнобой, быстрее загрузить запись в личный кабинет.
Когда распознавание встраивается в собственный продукт, n8n и Google Drive становятся лишними звеньями. Тогда надёжнее вызывать Speech-to-Text API напрямую и самим решать, где хранить записи и тексты.
| Вариант | Когда подходит | Где ломается | Что на выходе |
|---|---|---|---|
| Шаблон n8n | записи копятся в Drive, расшифровки нужны там же без ручной работы | нужен n8n, OAuth Google и настройка окна ожидания для длинных записей | .txt-файл в выбранной папке Drive |
| Личный кабинет | разовые записи, ничего настраивать не хочется | каждый файл загружается вручную | текст в кабинете |
| API напрямую | своё приложение или сервис | нужен разработчик | JSON, текст, SRT или VTT |
Сколько стоит и где обрабатываются данные
Сам шаблон и нода ничего не стоят, код ноды открыт под лицензией MIT. Деньги списываются только за распознанные минуты: от 0,29 ₽ за минуту, без подписки, и баланс не сгорает. Час записи обойдётся от 17 ₽ (60 минут по 0,29 ₽). Тестовые минуты для проверки выдаём по запросу. Google Drive и n8n тарифицируются отдельно, по условиям их владельцев.
Файл уходит из Drive в ваш n8n и дальше в API Palatine Speech, который стоит в четырёх ЦОД уровня Tier III в России. Обработка идёт по 152-ФЗ, канал защищён TLS, на записях клиентов модели не обучаются. Сам файл при этом остаётся в вашем Google Drive и подчиняется правилам Google, поэтому для чувствительных записей решение о том, где хранить исходники, остаётся за вами.
Нода Palatine Speech в воркфлоу
Так выглядят параметры ноды в шаблоне и то, что она отдаёт следующему шагу.
Установите ноду
Settings → Community Nodes → n8n-nodes-palatine-speech.
Импортируйте шаблон
Со страницы n8n.io или JSON-файлом, затем выберите папки и добавьте ключи.
Положите запись в папку
Текст появится .txt-файлом в папке расшифровок.
{
  "name": "Palatine Speech Transcription",
  "type": "n8n-nodes-palatine-speech.palatineSpeech",
  "parameters": {
    "model": "palatine_large_highspeed",
    "binaryProperty": "data"
  }
}{
"task": "transcribe",
"source_file": "Созвон с клиентом.m4a",
"model_used": "palatine_large_highspeed",
"transcription": "Добрый день! Давайте сверим сроки по договору..."
}- Шаблон и нода
- бесплатно
- Распознавание
- от 0,29 ₽/мин

Ответы на вопросы
Не нашли ответ на свой вопрос? Напишите нам
Нужно ли платить за шаблон или ноду?
Нет, в самом шаблоне и ноде платить не за что: оба бесплатны, нода открыта под MIT. Счёт идёт только за распознанные минуты, час записи обойдётся от 17 ₽.
Работает ли шаблон в n8n Cloud?
Да, шаблон работает в обеих версиях. В Cloud выбирают верифицированную ноду Palatine Speech, если она доступна в рабочем пространстве, на своём сервере ставят пакетом через Settings → Community Nodes. Разница в Google: на собственном сервере OAuth-клиент создаётся в Google Cloud, подробности в разделе про учётные данные на странице.
Почему нода падает с ошибкой polling limit?
По умолчанию нода опрашивает статус каждые 500 мс и делает до 200 попыток, то есть ждёт около 100 секунд. Для длинных записей увеличьте Polling Interval (Ms) и Max Poll Attempts в параметрах опроса ноды Palatine Speech.
Какие файлы обработает шаблон?
Любые записи, у которых тип начинается с audio/ или video/, либо с типовым расширением (mp3, wav, m4a, mp4 и ещё несколько, полный список в таблице нод на странице). Из расширений фильтра в списке форматов Palatine Speech нет только WebM: такой файл проверьте на коротком примере.
Не зациклится ли воркфлоу на собственных .txt?
Нет, фильтр Only Audio or Video Files пропускает только записи, а .txt и документы игнорирует. Тем не менее в описании шаблона рекомендуют сохранять расшифровки в отдельную папку и фильтр не отключать.
Можно ли получать сводку или разметку по спикерам?
Да. Замените в ноде Palatine Speech операцию Transcribe на Summarize со сценарием meeting_summary или на Diarize. Diarize умеет отдавать результат в SRT или VTT. Поле с результатом на выходе ноды проверьте и подставьте его в Convert to File.
Как быстро появится расшифровка в папке?
Не мгновенно. Триггер опрашивает Drive раз в минуту, после этого файл скачивается, а нода создаёт задачу и ждёт результат. Общее время зависит от длины записи и от настроек опроса ноды, точных цифр для шаблона мы не обещаем.
Где обрабатываются записи?
Запись идёт из вашего Drive через ваш n8n в российские ЦОД Palatine Speech. Исходный файл при этом остаётся в вашем Google Drive и подчиняется правилам Google.